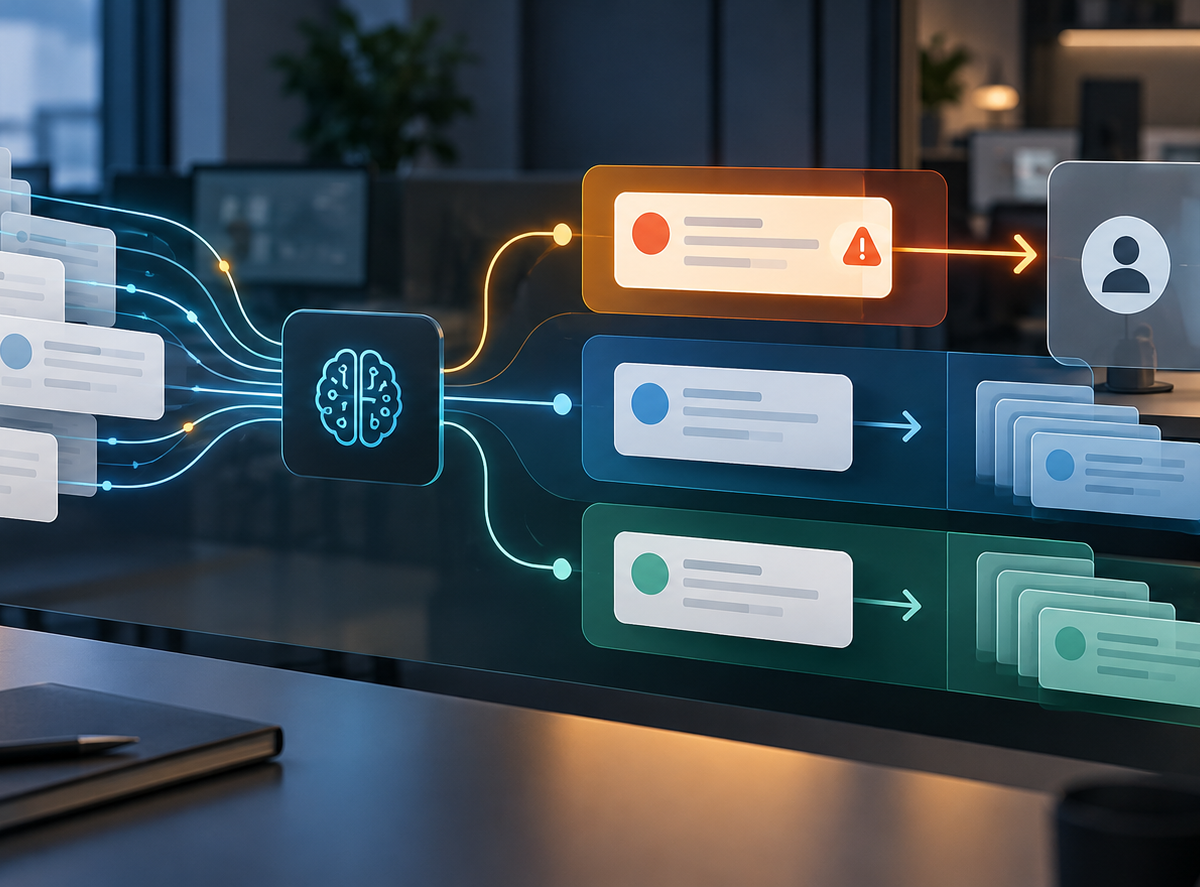
Usar IA para priorizar chamados de suporte sem deixar urgências para trás exige separar duas decisões: primeiro, classificar do que o ticket trata; depois, aplicar impacto, urgência e regras do negócio para ordenar a fila. A IA pode sugerir tema, equipe e sinais de risco, mas casos críticos e classificações incertas precisam de revisão humana.
Neste guia, você vai montar um piloto controlado, comparar automação com regras fixas e medir o erro que realmente importa: o chamado urgente que ficou esperando.
Classificar não é o mesmo que priorizar chamados
Classificação responde perguntas como “qual é o assunto?”, “qual produto está envolvido?” e “qual equipe deve atender?”. Prioridade responde “o que precisa ser visto primeiro?”. Misturar as duas decisões cria atalhos perigosos. Um ticket de cobrança pode ser rotineiro ou indicar uma duplicidade que bloqueou a operação do cliente.
Uma estrutura simples separa os campos:
| Decisão | Exemplos de saída | Uso no fluxo |
|---|---|---|
| Tema | cobrança, acesso, entrega, erro técnico | Encaminhar para a equipe certa |
| Produto ou unidade | sistema A, loja B, contrato C | Direcionar para o especialista |
| Idioma | português, espanhol, inglês | Escolher a fila ou o atendente |
| Impacto | individual, equipe, operação parada | Calcular a consequência |
| Urgência | baixa, média, alta, crítica | Definir o tempo de resposta |
| Confiança | alta ou abaixo do limiar adotado | Automatizar ou pedir revisão |
A documentação de triagem inteligente da Zendesk mostra esse princípio na prática: o sistema classifica tema, sentimento, idioma e entidades, associa confiança às classificações e permite que agentes corrijam os campos. Essas informações podem alimentar roteamento e priorização, mas não tornam sentimento sinônimo de urgência.
Um cliente irritado pode relatar um problema pequeno. Outro pode escrever de forma calma que toda a equipe perdeu acesso ao sistema. Por isso, sentimento deve ser apenas um sinal auxiliar. Impacto operacional, prazo contratual, segurança, pagamento não reconhecido e indisponibilidade total merecem regras próprias.
Como desenhar a triagem automática de tickets
Comece pela taxonomia, isto é, pela lista de categorias que a empresa realmente usa. Evite criar dezenas de rótulos logo no início. Se dois rótulos sempre levam à mesma equipe e ao mesmo tratamento, talvez devam ser um só.
Depois, transforme a política de atendimento em perguntas fechadas:
- Qual equipe deve receber o chamado?
- Qual produto ou processo está envolvido?
- Há sinal de operação parada?
- Há menção a acesso indevido, fraude ou pagamento não reconhecido?
- Qual é o nível de impacto informado?
- A confiança da classificação supera o limiar definido no piloto?
IAs classificadoras como o Jev podem entrar nessa etapa. Em vez de redigir uma resposta para o cliente, o modelo recebe o texto e devolve uma decisão entre opções previamente definidas, acompanhada de probabilidades e confiança. A TypeSafe, responsável pelo Jev, descreve o modelo como voltado a decisões tipadas que o software pode usar, com limiares para agir automaticamente ou encaminhar a uma pessoa.
Na prática, você pode pedir ao classificador que escolha entre “financeiro”, “suporte técnico”, “comercial” e “segurança da conta”. O código do seu sistema usa a resposta para preencher o campo de categoria. Em uma segunda decisão, pode atribuir uma nota de impacto. As regras do negócio combinam esses resultados com dados objetivos, como tipo de cliente, serviço afetado e tempo restante do acordo de nível de serviço.
Esse desenho é mais controlável do que pedir a uma IA generativa que “leia e resolva tudo”. As opções são conhecidas, a saída cabe nos campos do help desk e um resultado incerto pode ser desviado para a fila humana. O Jev é um exemplo, não uma escolha automática: compare-o com classificadores do próprio sistema de atendimento e com outros modelos usando os seus tickets anonimizados.
Faça um piloto com custo do erro
Separe uma amostra de chamados históricos, remova dados pessoais que não sejam necessários e peça a pessoas experientes para marcar a categoria e a prioridade esperadas. Essa marcação vira a referência do teste. Se a equipe divergir muito entre si, o problema pode estar na política de atendimento, não no modelo.
Monte também uma matriz de custo do erro:
| Erro | Consequência provável | Tratamento inicial |
|---|---|---|
| Enviar para a equipe errada | Retrabalho e demora | Permitir correção rápida e registrar reatribuição |
| Marcar rotina como urgente | Fila inflada | Revisar regra e reduzir peso do sinal |
| Deixar urgência como rotina | Risco operacional ou perda do prazo | Limiar conservador e revisão obrigatória |
| Automatizar com baixa confiança | Erros imprevisíveis | Encaminhar para triagem humana |
Compare três modos no mesmo conjunto:
- Regra fixa: palavras-chave e campos estruturados definem o destino.
- Sugestão da IA: o classificador preenche campos, mas uma pessoa confirma.
- Automação restrita: somente casos de baixo risco e alta confiança seguem sem confirmação.
Exemplo hipotético: uma empresa recebe chamados por e-mail, portal e WhatsApp. Durante o piloto, ela não mede apenas a porcentagem geral de acertos. Registra quantas urgências reais foram rebaixadas, quantos tickets precisaram ser reatribuídos e quanto tempo a triagem humana gastou. Mesmo que a classificação total pareça boa, um único tipo de falso negativo pode justificar uma regra de revisão obrigatória.
As métricas úteis são taxa de reatribuição, urgências não detectadas, falsos alarmes, tempo até a primeira triagem e proporção enviada à revisão. Acompanhe os resultados por categoria. Uma média geral pode esconder que “acesso bloqueado” funciona bem enquanto “pagamento não reconhecido” ainda falha.